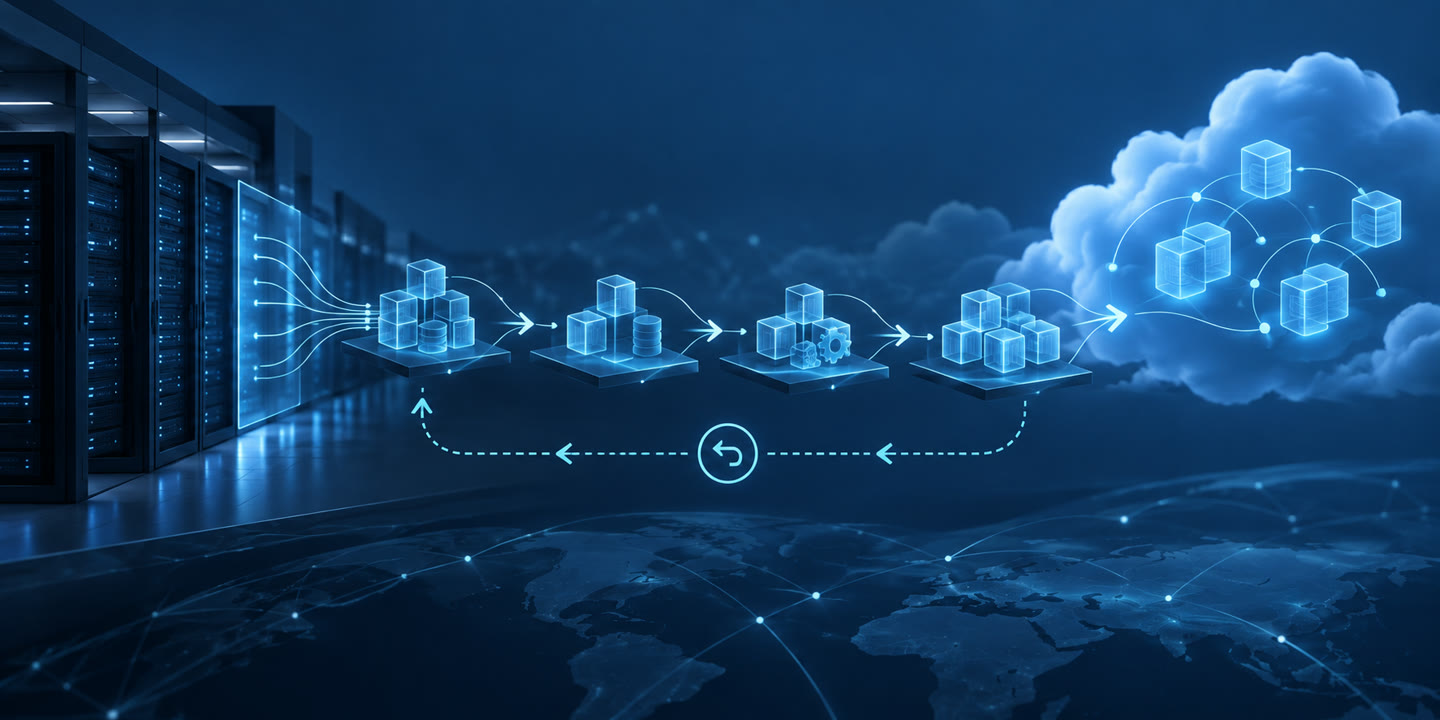
O cronograma de uma migração raramente falha por causa do clique final. Os problemas aparecem antes: uma aplicação depende de um servidor que não entrou no inventário, uma integração usa um endereço fixo ou o teste foi feito sem reproduzir o cenário que os usuários realmente utilizam.
Por isso, planejar a migração é mais do que decidir em que data desligar a origem. A avaliação precisa registrar o que será movido, como os componentes se relacionam e quais condições precisam estar verdadeiras para considerar a mudança concluída.
O piloto serve para aprender
Uma boa primeira onda não é necessariamente a menor carga nem a mais crítica. É uma workload cuja arquitetura e impacto sejam compreendidos, que permita testar conectividade, autenticação, desempenho, backup, monitoramento e suporte sem colocar a operação principal em risco.
Antes de cada onda, documente:
- serviços e integrações incluídos, dependências externas e responsáveis;
- janela de mudança, comunicação e critérios de entrada;
- testes funcionais e técnicos, com resultados esperados;
- condição de sucesso e quem tem autoridade para aprová-la;
- plano de retorno, incluindo limite de tempo e mudanças que precisariam ser revertidas.
O plano de retorno não é uma promessa de que qualquer situação pode ser desfeita sem consequências. Dados gravados depois do cutover, alterações de configuração e dependências entre sistemas precisam ser considerados. O caminho deve ser testado e compatível com o desenho da migração.
Na preparação, valide a workload em ambiente de teste e resolva problemas de compatibilidade antes da produção. A documentação do Cloud Adoption Framework recomenda usar os dados da avaliação para localizar dependências e validar a funcionalidade antes do cutover.
Uma onda termina quando a operação foi validada, não apenas quando a VM iniciou. Essa diferença ajuda a evitar que “migrou” seja confundido com “está pronta para o negócio”.
Transforme dependências em sequência de trabalho
Uma lista de máquinas não revela sozinha o que pode ser movido primeiro. Relacione aplicação, banco, identidade, DNS, certificados, compartilhamentos, integrações e responsáveis. Procure acoplamentos: um serviço pode parecer independente até depender de arquivo em servidor legado ou autenticação em domínio local.
Classifique cada carga pelo impacto de indisponibilidade, sensibilidade dos dados, dependências, desempenho e esforço de modernização. Uma avaliação qualitativa, com justificativa, é mais honesta do que uma pontuação artificial quando o inventário ainda está incompleto. Use ferramentas de descoberta como apoio; confirme cada dependência com o dono técnico e com observação da operação.
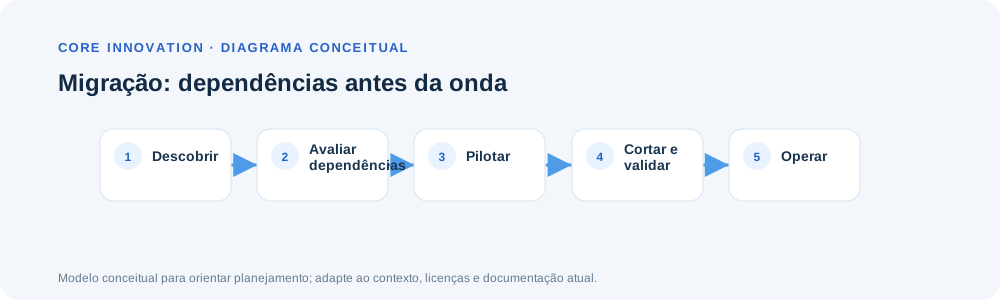
Uma onda pode seguir esta sequência: confirmar proprietário técnico e patrocinador; decidir o que será migrado como está e o que será redesenhado; preparar identidade, conectividade, observabilidade e backup; ensaiar o fluxo representativo; executar o corte e decidir formalmente entre seguir ou retornar. Para cada etapa, deixe claro quem aprova.
Defina evidências de aceite antes da mudança
“A VM responde a ping” não é critério suficiente para uma aplicação. Combine testes de autenticação, transação funcional, integração com sistemas vizinhos, telemetria, alerta, restauração de backup e acesso do suporte. Os limites de desempenho precisam vir da linha de base ou do dono da aplicação, não de um número universal.
Escreva condições de parada. Se a integridade dos dados não puder ser confirmada, se uma dependência estiver indisponível ou se a janela segura terminar, a equipe deve saber quem decide. O plano de retorno precisa considerar gravações após o corte e possível divergência de dados; restaurar uma máquina não reconcilia automaticamente sistemas. O diagrama é roteiro conceitual, não evidência de uma migração executada.